La semana pasada lancé un nuevo blog llamado delishios, cuya url es delishios.blogspot.com
Así como tuitiar.com es el blog en donde se pueden ver todos los tweets que los usuarios argentinos postean en twitter, delishios es una lista de los links que los usuarios hispanos están bookmarkeando en delicious.com, el sitio de "social bookmarking" de yahoo, altísimamente recomendado así que vayan y regístrense. (si no conocés delicious podés leer este post, o ver este video en inglés).
Con delishios se puede saber cuales son los sitios que la comunidad hispana considera interesantes, ya que son sitios que los usuarios están guardando para sí mismos, para volver a consultarlos en el futuro.
La lista de links de delishios se refresca permanentemente tomando la información de delicious y pegándola en el blog, y es realmente interesante. Se descubren sitios buenísimos.
(nota para nerds: delicious tiene un javascript que no está permitido en Wordpress así que este nuevo blog también lo hice en Blogger, contra mi voluntad).
Espero que les guste.

jueves, 30 de octubre de 2008
Nació DELISHIOS

miércoles, 15 de octubre de 2008
Influenciando el snippet de Google
En la jerga SEO, se llama "snippet" al texto que pone Google debajo del título del site de cada resultado de búsqueda que encontró. Por ejemplo, en el caso de este blog, la página de resultados puede mostrar algo así:
Daniel Serra en la Web - 10 visitas - 6 Oct
Voy a Google Images, pongo Daniel Serra, y si bien muchas de las imágenes que aparecen son mías, veo con asombro que las que están primeras no son las que ...
daniserra.blogspot.com/ - 90k - En cache - Páginas similares - Anotar esto
Donde el texto "Voy a Google Images...no son las que..." es el snippet al que hago mención.
Ese texto por lo general es una parte del contenido de la página encontrada, en el cual Google muestra un par de renglones que contienen la keyword que uno estaba buscando. El objetivo es ayudar al usuario a ver el contexto en la cual la keyword aparece mencionada en ese sitio, y así saber si esa página puede ayudarlo.
Pero en el caso que esa keyword sea importante para el sitio encontrado, es posible influenciar el snippet incorporando un Meta Description Tag, y eso es lo que acabo de hacer.
Si hacen View -> Source en el explorer, van a ver que una de las líneas de código de arriba de todo es una que dice: meta content="Daniel Serra explica..."
Eso es lo que yo querría que aparezca en el snippet de este blog. No va a tener ningún efecto en el resultado de búsqueda, pero me parece mejor influenciar ese texto, que dejarlo librado al criterio del bot, que pone cosas como la que están arriba, bastante chotas...
Vamos a ver si funciona.
miércoles, 8 de octubre de 2008
PAGE RANK 3 !!!!!

Guau!! Esto sí que no me lo esperaba.
El blog tiene Page Rank 3, que no es poco para un blog como este. Que emoción!!
Para que tengan como referencia,
- ProBlogger tenía PR 4 el año pasado.
- Bocabit.com tiene PR 4.
- El blog de Conz también tiene 4.
- El blog de los Ziegler en Canada, otro con 4.
...y estoy hablando de blogs grosos.
miércoles, 24 de septiembre de 2008
SEO Simplificado
Me encantó este post del gurú de SEO randfish porque realmente hace un esfuerzo por definir lo que es verdaderamente importante a la hora de optimizar un sitio para una keyword.
Según randfish, tenés el 90% del trabajo de optimización hecho, cubriendo estos cuatro aspectos:
1) Uso de la keyword y relevancia con el contenido del sitio.
Obviamente, las keywords tienen que estar presentes en el contenido, pero de una manera relevante, no forzada. Hablar de SEO o de la keyword Daniel Serra es natural para este sitio. Hablar de fútbol no (aunque con el ciclón primero, estaría bueno...).


miércoles, 27 de agosto de 2008
Todos los Ranking Factors a tener en cuenta
sábado, 23 de agosto de 2008
La fórmula del PageRank
 Que se lee así: el PageRank de la página "i" es la sumatoria del PageRank de cada página "j"que tiene un link apuntándole a "i", dividido por la cantidad de links salientes que tiene esa página "j". El universo de páginas que linkean a "i" está representado por la letra B.
lunes, 18 de agosto de 2008
El lugar donde buscar cualquier tema de SEO
sábado, 28 de junio de 2008
¿Cómo funciona el buscador de Google?
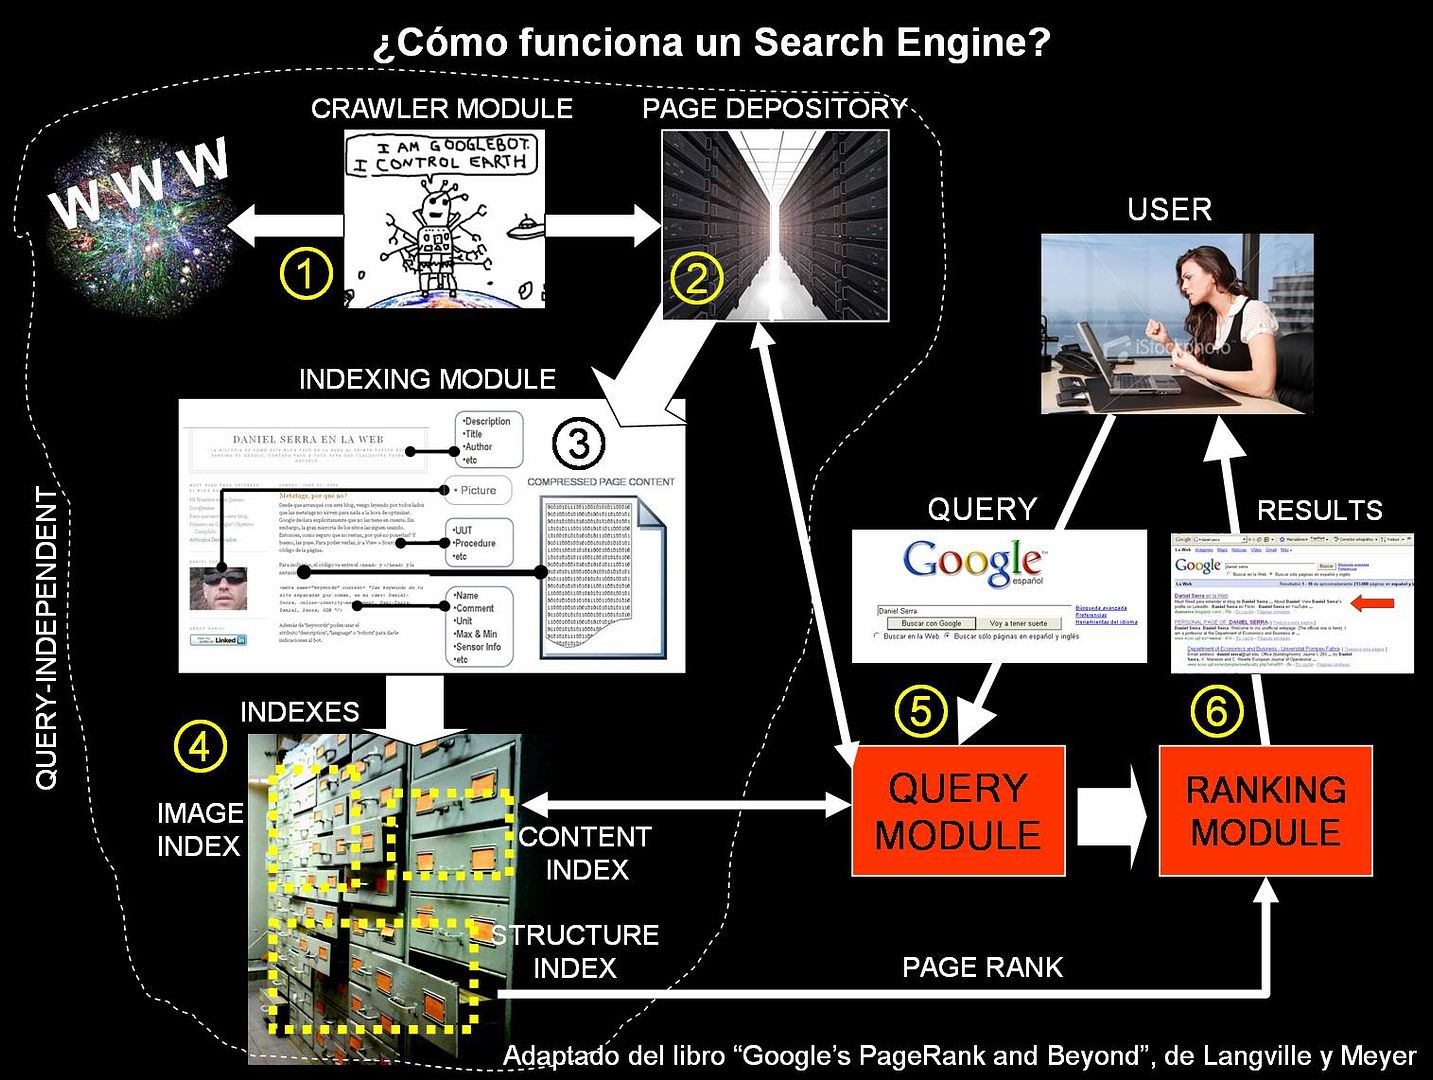 Recomiendo abrir la imágen en otra ventana, clickearla para que se agrande, y consultarla a medida que se lee el post. Vale la pena.
1) Todo empieza con un bot (también llamado crawler, o spider) que se ocupa de recolectar la información que está desparramada por los miles de servers que forman la world wide web. No hay en ningún lado una lista de los sitios web existentes en un determinado momento, las empresas que dan servicio de Search Engine (Google, Yahoo!, etc) deben auto-generarse esa lista. El bot no es ni más ni menos que un programita que visita páginas de internet de manera automática, las copia, las manda al “Page Depository”, luego visita cada uno de los links que tenía esa página y así sucesivamente. De esa manera, recorre la gran mayoría de las páginas de internet existentes y relevantes (Google tenía 8,1 billones a Noviembre del 2004), aunque son muchas las que se le escapan. Ahora, para mantener el “Page Depository” actualizado, las páginas que cambian en forma diaria también deben ser actualizadas diariamente. Para eso existe un bot especial llamado “fresh bot” que visita más frecuentemente los sitios que refrescan su contenido en forma permanente.
2) El “Page Repository” es el caché, o sea, el lugar donde se guarda la última actualización de una determinada página según la copió el bot. Toneladas de información acumulada en discos rígidos. Cuando se hace una búsqueda en Google, al final de cada resultado aparece un link que dice “En caché”. Ahí se puede ver la página que está guardada en el “Page Repository” correspondiente a la última vez que el bot pasó a visitarla. Por supuesto que la página real puede haber cambiado desde ese momento. Acá hay un ejemplo de una página del caché de este blog.
3) El “Indexing module” toma cada página nueva del “Page Repository” y extrae la información más importante, creando una versión comprimida que luego va a ser utilizada en los índices. Esa información incluye: título, descripción, anchor texts, texto en bold o en tamaño mayor, links hacia otras páginas, texto, etc.
4) Con la información extraída en el “Indexing module” se confeccionan los distintos “Indices”. Los más importantes son:
- El “Content Index”: indica en que páginas se encuentran cada palabra de texto escrita en el contenido de todos los sitios del “Page Repository”. Funciona igual que el índice alfabético que está al final de los libros: buscás una palabra y el índice te indica en que páginas del libro aparece esa palabra. Las palabras muy comunes tipo “el”, “un”, “a” discriminan tan poco y tendrían una lista de páginas tan grande que son ignoradas por el buscador.
- El “Structure Index”: como su nombre lo indica tiene la información de cómo linkean las páginas entre sí, conociendo para cada página sus links entrantes y salientes. Con esta información se calcula el PageRank.
- Otros índices especiales, como índice de imágenes, archivos pdf, etc.
5) Todo este proceso sucede de manera constante, durante el día y la noche, más allá de que alguien entre a hacer una búsqueda o no. Es decir, es “query-independent”. Supongamos ahora que un usuario ingrese a Google a hacer una búsqueda (lo que sucede más de 300 millones de veces por día). Esa búsqueda entra al “Query Module”, donde se transforman las palabras buscadas en números. Luego éste consulta al “Content Module” para definir cuál es la lista de páginas que tienen contenido relevante de acuerdo a esas palabras buscadas, ordena esa lista según el “content score” (ponderando las páginas que tienen la palabra buscada de manera destacada), trae las páginas relevantes del “Page Repository” y manda todo al "Ranking Module".
6) Finalmente el “Ranking Module” toma la lista de páginas relevantes, busca el PageRank de cada una en el “Structure Index”, calcula el “overall score” de cada página en función del “content score” y el PageRank, re-ordena los resultados según este “overall score” y manda esa lista al usuario. Chin-pum. Todo eso a la velocidad de la luz.
Dediqué 2 horas de un martes a la noche para escribir este post, incluyendo el armado de la imagen. Creo que faltaba una explicación profunda pero clara de cómo funciona un buscador.
Una actualización: me gustó el videito de Matt explicando todo esto de una manera más basica, pero más divertida:
miércoles, 25 de junio de 2008
La importancia del título del post
Si van a la barra de la izquierda y en el box de "Búsqueda Personalizada en Google" hacen un Search para la keyword Daniel Serra, después de la home, el primer resultado que va a aparecer es el post del 29 de Enero "Daniel Serra en la web, para celulares".
¿Por qué ese post le gana a los otros? Simplemente porque ese post tiene la keyword Daniel Serra en su título (y por lo tanto en la url dado que Blogger utiliza el título del post para generar el permalink). Un buen indicio de la importancia que tiene ese aspecto en la optimización del sitio.
Como dice el gran libro "Google's PageRank and Beyond", el ranking de resultados depende de dos factores: el "content score" y el "popularity score" (voy a profundizar mucho más estos aspectos en el futuro). La combinación de ambos (con ponderaciones que nunca sabremos) determinan un "overall score" que define el orden de los sitios en la página de resultados.
El "popularity score" es intrínseco de la página, y totalmente independiente del query que el usuario esté haciendo en ese momento (en mi caso, Daniel Serra). Se calcula a partir del "popularity score" de las páginas con links entrantes (lo que genera un problema matemático de carácter iterativo) y Google lo mide a través del conocido PageRank. Entonces, el primer concepto (obvio pero fundamental) es que el PageRank es query-independent.
Por otro lado, el "content score", como su nombre lo indica, depende únicamente del contenido (no importándole su popularidad, cantidad de links entrantes, visitas, etc) y pondera al título de la página, su descripción, anchor texts (de los links entrantes), y palabras con font más grande o negritas, por encima del resto del contenido. Como es de suponer, el "content score" de una página es diferente para cada query, y por lo tanto es query-dependent.
Entonces, cuando un usuario hace una búsqueda de una palabra, se calculan los "content scores" de las páginas relacionadas con esa palabra buscada ("relevant pages") generándose un primer ranking. Luego otra aplicación llamada "Ranking Module" va a tomar esa lista y la va a ponderar utilizando el "popularity score" (Page Rank) intrínseco de cada página, calculando así el "overall score", que sirve para ordenar los resultados y dispararlos a nuestro browser en una fracción de segundo.
El post "Daniel Serra en la web, para celulares" no gana por tener mayor popularidad (tiene PR1 como varios otros posts), pero al tener la palabra buscada en el título gana mucho content score lo cual la empuja arriba de todo.
martes, 10 de junio de 2008
El profesor visitó el blog!
Es un verdadero placer anunciar que dos nuevos Daniel Serra visitaron el blog (ambos en el mismo día). Los comentarios que dejaron se pueden leer acá.
El primero es de Valencia, y actualmente vive en Barcelona (el año pasado estuve en Valencia, más o menos en esta época, te hubiera ido a visitar; y de ahí me fuí a correr el encierro a San Fermín). Espero que nos cuente un poco más de su vida. El segundo es nada más ni nada menos que Daniel Serra el profesor de la Universidad de Pompeu Fabra, tan citado en varios posts por la simple razón de que es quien tiene el sitio más fuerte en Google, cabeza a cabeza con este blog. Se está generando un network de Daniel Serras, lo cual me parece simplemente genial. El profesor me dice que además hay otro Daniel Serra profesor, francés, que vive en Montpellier.
Justo yo tenía que ser el que vive en el tercer mundo?? : )
Chiste, la verdad que después de haber vivido 4 años en el exterior, volví porque me encanta Buenos Aires.
Esta no es la primer visita de un Daniel Serra al blog, ya nos había visitado el nacido en Mayorca a mediados de febrero, comentado en este post.
Bienvenidos! Muchas gracias por haber escrito comentarios. Me encantaría que sigan participando. Estamos en contacto.
sábado, 24 de mayo de 2008
Resultados instantáneos
Antes de ayer hice los cambios a los Alt tags mencionados en el post anterior y en dos días ya entraron cuatro fotos a la primera página de Google Images. Impresionante:

La verdad, estoy sorprendido por la velocidad de los cambios. Lo que demuestra que realmente el bot es muy sensible a los Alt tags para rankear las imágenes.
Ya hay cuatro...mi objetivo es ver si puedo meter ocho fotos en la primera página. Veremos...
lunes, 5 de mayo de 2008
Primero en Google! Objetivo cumplido!
Luego de cuatro meses de haber lanzado el blog con el único objetivo de lograr la primera posición en Google (y divertirme y aprender en el proceso) y a un día de haber sido beneficiado con un PageRank de 2, puedo ahora decir:

Y todo el proceso, paso a paso, está escrito para que cualquiera lo haga. Sólo hay que seguir el blog desde el 1ro de Enero hasta hoy (OK, se pueden saltear los posts más chotos).
Quiero agradecer a todos los que me dieron consejos, los que me dijeron "que divertido lo que estás haciendo", los que se lo contaron a sus amigos, los que leen los posts aunque sea de vez en cuando, los que me prestaron literatura (gracias Bosaz, ya te voy a devolver el libro), los que dejaron comentarios o mandaron mails, los que me linkearon, los que se inspiraron y empezaron un proyecto parecido (grande Ale) y a Seth que me inspiró a hacerlo.
Un especial agradecimiento para los dos bloggers pro que me siguieron desde el principio: Los Ziegler y Sin Serif.
Por supuesto que el blog sigue, hay que mantener la pole position (esto se puede dar vuelta en cualquier momento, ya lo saben) y para eso voy a seguir aplicando todo lo que aprenda de SEO.
Pero voy a dejar este post por lo menos una semana, así le doy tiempo a los más vagos y a los más tímidos a que me dejen sus comentarios.
Saludos a todos y DEJEN COMENTARIOS PLEASE, así quedan inmortalizados en este glorioso post : )
Como este post está rankeando muy bien, le voy a agregar unos links para repartir el "juice" con otras landing pages:
- Imágen de Daniel Serra
- Post en inglés de Daniel Serra
- Home blog Daniel Serra

viernes, 2 de mayo de 2008
¿Lo querés? Lo tenés!!


domingo, 30 de marzo de 2008
¿Está Google confundiendo idioma de interfaz con idioma de búsqueda?
ATENCION! EL IDIOMA DE TU INTERFAZ DE GOOGLE AFECTA A LOS RESULTADOS DE LA BÚSQUEDA!!!! UN DESASTRE!!!
Si vas al link de Preferencias que está en la Home de Google, te encontrás con las siguientes dos opciones de personalización:
- El idioma de la interfaz (interface language): es el idioma en el que están escritos los textos, consejos y mensajes de la propia página de Google. Ejemplo: si querés que al pie de página de la home diga "Programas de publicidad - Tecnología para Empresa - etc" (español) o bien "Advertising Programs - Business Solutions - etc" (inglés).
- El idioma de búsqueda (search language): es la opción que se utiliza cuando uno quiere limitar la búsqueda a sitios escritos en determinados idiomas. Ejemplo: si marco la opción recomendada Buscar en la Web páginas escritas en cualquier idioma, le estoy diciendo que busque en toda su base de datos, independientemente del idioma, y si le digo Español, le estoy indicando que limite la búsqueda a páginas escritas en ese idioma.
Ahora, presten atención: voy a hacer una búsqueda de la keyword Daniel Serra, dejando el idioma de búsqueda fijo en la opción "Buscar en la Web páginas escritas en cualquier idioma (recomendado)" que en inglés está como "Search for pages written in any language (Recommended)" y voy a comparar los resultados con el idioma de interfaz seteado en Español y después en Inglés. LOS RESULTADOS DEBERÍAN SER LOS MISMOS, NO?
PERO SON DISTINTOS!! QUE HORROR DE GOOGLE!!!
Los resultados son totalmente distintos. Increíble. Lo mismo pasa con cualquier otra keyword que probé (si busco mp3, con la interfaz en español el primer sitio es Wikipedia, y en inglés el primero es mp3.com). No puede ser que los resultados dependan del idioma de interfaz, que para cualquier persona bilingüe es indiferente. La Search Results Page debería ser totalmente independiente de este.
Alguien me puede dar una explicación lógica? Gracias Toni que me ayudaste a encontrar este moco...
sábado, 15 de marzo de 2008
Selección de keywords
Uno de los aspectos más importantes en el proceso de SEO es la definición de las keywords, o sea, la elección de las batallas que uno va a pelear en los buscadores vs los otros sites.
En mi caso, la keyword principal es, ya lo saben,"Daniel Serra".
Pero tengo otras keywords secundarias:"Dani Serra"y "Online Identity Management" (el término que me animé a definir en Wikipedia).
Todavía con menor relevancia: "OIM" (las siglas de Online Identity Management), "blog Dani Serra", "Googleate", y la máxima aspiración que sería lograr alguna mención con "Serra" o con "Daniel" (imposible por el nivel de competencia que tienen esas palabras, ver post Googlealo a Matt).
También quiero que mis fotos rankeen bien en el buscador de imágenes de Google (que a mi juicio es bastante malo, porque generalmente los resultados tienen poco que ver con lo que se está buscando).
Según el libro "Search Engine Optimization. One Hour a Day" hay que ver tres aspectos de cada keyword elegida:
- Search Popularity: ¿se trata de una keyword muy buscada en los search engines?
- Relevance: ¿conecta bien esa keyword con el contenido de mi site?
- Competition: ¿cuántos otros sitios están peleando por esa misma palabra? ¿lo están haciendo bien?
En alguno de los próximos posts voy a mostrar herramientas para evaluar esos aspectos, para cada una de mis keywords elegidas.
martes, 4 de marzo de 2008
Wikipedia, un gran usuario del "no follow"
En los FAQs de Wikipedia leí que cada vez que se ingresa una dirección url en uno de sus artículos, automáticamente se agregan instrucciones "no follow" al código, algo que a priori puede sonar medio antipático. Si no te acordás que era el "no follow", leer acá.
Para ver la evidencia de esa declaración fuí a mi página de usuario de Wikipedia y ví el código. En la imágen muestro una parte de ese código, y en rojo marqué los "no follow".
Miren que impresionante. Cada uno de mis links tiene un "no follow" perfectamente ubicado (hay que ponerlo así: dirección url"rel="nofollow">anchor text).
La conclusión interesante es que, por esta razón, todo lo que uno haga en Wikipedia puede sumar tráfico pero no va a sumar PageRank. Sin embargo los artículos de Wikipedia sí tienen alto PageRank, dado que todo el mundo los linkea desde afuera. Eso no parece muy recíproco que digamos, aunque es perfectamente comprensible: a Wikipedia no le interesa gente que edite los artículos como parte de una estrategia de Search Engine Optimization (ganar PageRank), pero a Google sí le interesa que los artículos de Wikipedia rankeen alto dado que son buenos.
PD: dicho todo esto, yo apoyo el NO NOFOLLOW en este blog. Para ver más leer Mi Política sobre el No Follow.
lunes, 3 de marzo de 2008
Blogging desde Barbados
 Estoy en un crucero y recién hoy logré una conexión wifi razonable, así que estoy de vuelta en el blog.

martes, 26 de febrero de 2008
Si la keyword fuera mi username...
En la mayoría de los lugares donde me registro, utilizo el username daniserra. Se me ocurrió ponerlo en Google y los resultados fueron sorprendentes:
- 1ero: mi página de Twitter
- 2do: este blog
- 3ero: mi página de Technorati
- 4to: un mirror de mi página de Twitter en greekshow.
- 5to: mi posición en la blogosfera.
- 6to: un comment de Los Ziegler en este blog.
- 7mo: otra página mía en Technorati.
- 8vo: el fotolog de un tocayo.
- 9no: mi página en bitacoras.com
- 10mo: un tweet mío en tweeter.
- Luego siguen Flickr, Blogoesfera, etc, etc.
Conclusión: si querés rankear alto, pensá en un utilizar alguna de tus keywords como username. Vas a tener gran parte del trabajo hecho.
domingo, 24 de febrero de 2008
Online Identity Management
Después de mucho navegar, ví que no existía un nombre adecuado para la actividad que estoy haciendo online. Si bien está claro que el objetivo de este experimento es aprender como se hace para que el blog llegue al primer puesto cuando se busque a Daniel Serra en Google, y eso se llama Search Engine Optimization, pensé que debería haber otro nombre para una actividad que abarque, de manera más amplia, todo el proceso de construcción y management de tu identidad online, no sólo a través de un blog y su optimización, sino a través de todos los sitios que reflejen la actividad que uno hace en internet.
Y como no encontré esa definición, decidí escribirla yo, y la puse en Wikipedia. La llamé Online Identity Management:
http://en.wikipedia.org/wiki/Online_Identity_Management

Estoy convencido de que la era de la participación anónima en internet terminó para siempre (para bien o para mal), nadie lee el blog ni acepta como amigo en Facebook al avatar de un anónimo. El término Online Identity Management lo leí por primera vez en este artículo, pero referido exclusivamente a como resolver un problema de mala reputación en internet. Para Wikipedia tomé ese nombre y le dí un nuevo significado.
Me encantó la experiencia de contribuir a Wikipedia con una página nueva, y saber que ahora está en manos de la comunidad, que puede mejorarla enormemente, o editarla de miles de maneras que a mi no me gusten. Pero de eso se trata Wikipedia. En esta página se puede seguir toda la evolución de las sucesivas ediciones. Más adelante la traduciré a español, si alguien se ofrece y lo quiere hacer, más que bienvenido.
Como este post está rankeando muy bien, le voy a agregar unos links para repartir el "juice" con otras landing pages:
- Imágen de Daniel Serra
- Post en inglés de Daniel Serra
- Home blog Daniel Serra
miércoles, 20 de febrero de 2008
Enroque de columnas
En el post "Desde el ojo del bot", en el que hablábamos de los Spider Emulators, habíamos hecho un diagnóstico en el cual salían unos aspectos claves para mejorar. Uno de esos puntos, el más importante, mencionaba que el bot lee el blog en un orden que no me es conveniente. Decía textualmente:
"¿Se lee el blog en el orden en que yo quiero que se lea? NO!! El bot lee primero la columna de posts y después la columna de la derecha. Y esa columna de la derecha tiene una densidad muy alta de keywords, con lo cual sería bueno correrla para la izquierda así el bot la lee primero".
Es importante que el bot encuentre las keywords lo más arriba posible, y como se ve, la columna de navegación que estaba en la derecha está llena de anchor texts con mi keyword (mi nombre).
Y hoy me animé a moverla a la izquierda (!!). Fue más fácil de lo que pensaba porque encontré en Blogger un template igual al anterior, pero con las columnas cambiadas.
Ahora el bot va a leer la columna de navegación primero, y va a encontrar 14 veces mi keyword (una keyword-density altísima), y luego va a pasar a la columna de posts en donde lo importante es poner el mejor contenido posible y por eso la densidad es mucho menor.
Este fue el cambio más importante que hice hasta ahora, fue gracias a un insight del libro, y si aprendí algo en este mes y medio, me animo a decir que cuando pase el bot se van a ver las mejoras en el ranking. Para eso hay que esperar tres o cuatro días...
Mientras tanto, sigo esperando la calificación de Page Rank, que es el gran tema que me falta. Paciencia...habíamos dicho que iba a tardar por lo menos dos meses.